前言
过去一年,各家大模型在长任务上的能力提升是有目共睹的。他们拥有更大的上下文窗口,更强的推理能力。
这些大模型如果直接运用到运维场景里,排障链路会长什么样子?
我们做过一个实验,让AI Agent去排查一个生产的故障问题。它需要做的是搜集多台机器的现场数据,分析定位根因,制定方案,执行修复。我们发现这里每一步都会在往模型上下文里堆信息,越跑越不稳定,到了分析阶段有很多细节都会丢失。
不是模型不够聪明,是有些问题是大模型的原生机制而带来的:
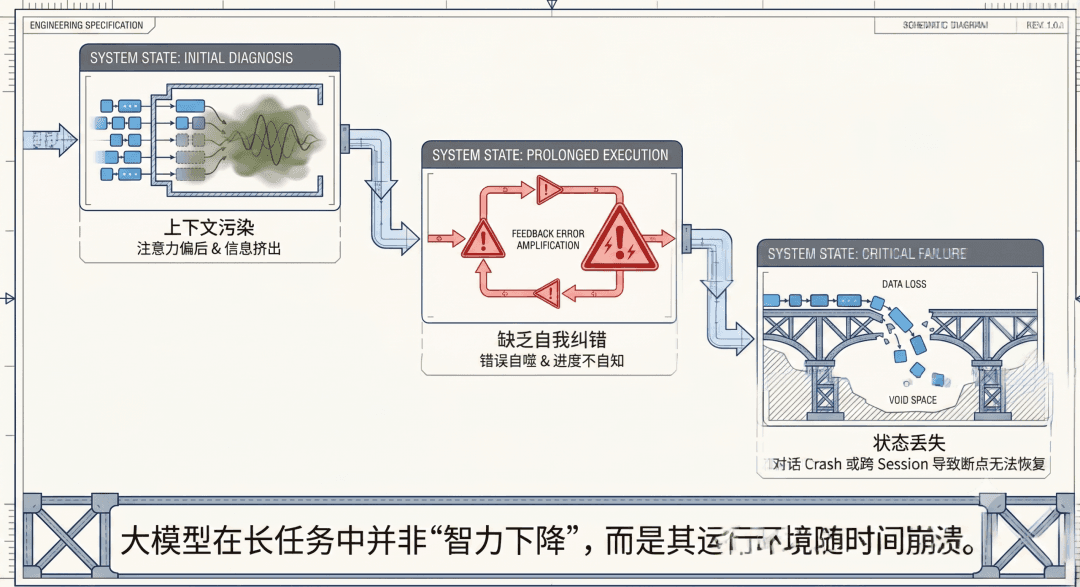
- 上下文污染。 在长任务里,模型面对的上下文不是越堆越厚,而是越堆越脏。主要受大模型的2个机制影响:
- 注意力偏后:比如采集10台机器的 SSH 输出,第1台机器的配置信息已经被第10台的日志淹没了。采集的内容越多导致推理越瞎。
- 信息挤出:context 窗口有限会导致早期关键结论被后续工具输出截断覆盖,大模型再也看不到自己之前发现了什么。
- 缺乏自我纠错。 长任务的执行链路里没有"质检员"。主要受大模型的2个机制影响:
- 错误自噬:模型自己前一步产生的错误或偏差留在上下文里,后续推理直接基于错误前提展开,小错变大错
- 进度不自知:Anthropic 发现在长任务中反复出现两个相反的表现,有时才做了一半就宣布完成,有时在一条走不通的路上死磕到底。两种极端源于同一个缺陷:模型缺乏对自己任务进度的准确感知
- 状态丢失。 大模型执行任务时靠长期记忆(Claude.md memory.md 知识库等)和短期记忆(context)组成上下文。任务进度只存在于对话 context 这一层,而这一层最不可靠,带来的就是当对话crash、compact和跨session的时候任务能不能从断点继续的问题。
那如果要让 AI 智能体可控的进入生产环境,可以稳定可靠的开展运维工作,我们可以通过哪些手段给AI大模型打补丁去改善模型上下文、规划、评估和执行稳定性的不足?
我们在两个方向做了尝试:
- 方向1:Agent Team — 把 Agent 按工具/上下文/权限拆开
- 方向2:Runbook — 用结构化约束让长任务可恢复可追溯
方向1: 把 Agent 按 工具/上下文/权限 拆开做多Agent设计
多 Agent 的错误姿势:照搬人类组织架构
以前 DevOps 运动说的 "You Build It, You Run It" 打破了开发和运维的墙,让写代码的人为自己的服务 on-call。这句话改变了整个行业的组织方式。
现在很多人把同样的直觉搬到了 AI 上。当你第一次面对用 Agent 做运维这个问题时,最自然的想法就是看你的团队有 DBA、有安全工程师、有监控工程师,可能就按这个模板来:一个 DBA Agent 管数据库、一个安全审查 Agent 管漏洞、一个监控 Agent 盯大盘。分工清晰,各管一摊。
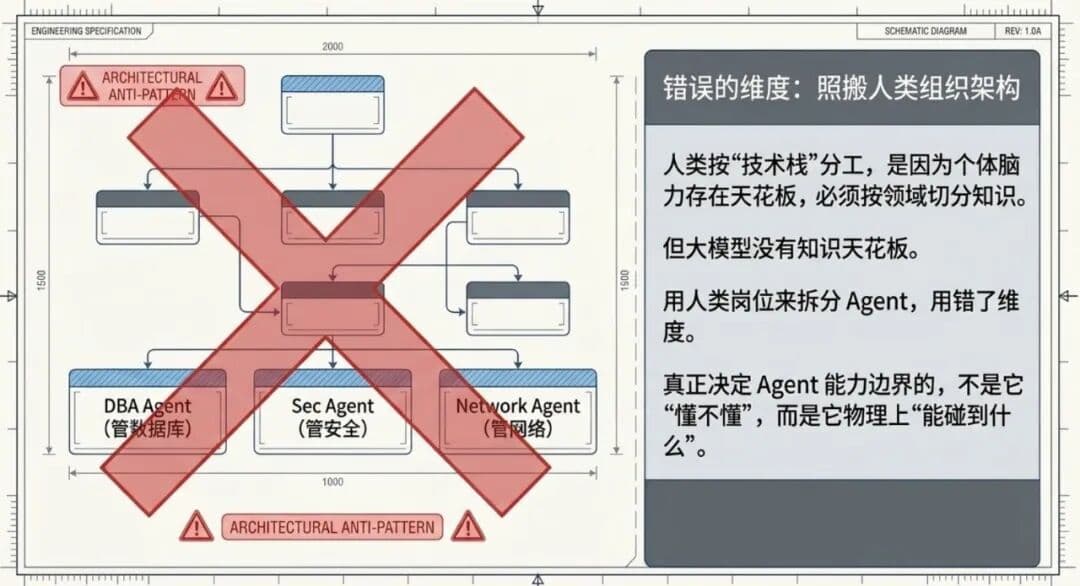
这个思路很诱人,因为人类几千年就是这么组织的。看似很明确的分工,会削弱大模型的能力,还会导致Agent之间的互相扯皮。Manus 创始人季逸超也明确指出:"不要用人类社会的分工逻辑去设计 Agent。人类需要分工是因为个体能力有限,而大模型没有这个天花板。"
给大模型按人类岗位设计是用错了维度。真正决定一个 Agent 能做什么、不能做什么的,不是它懂不懂,而是三个东西:上下文窗口、工具权限、推理退化。
正确的拆分维度:工具、上下文、权限
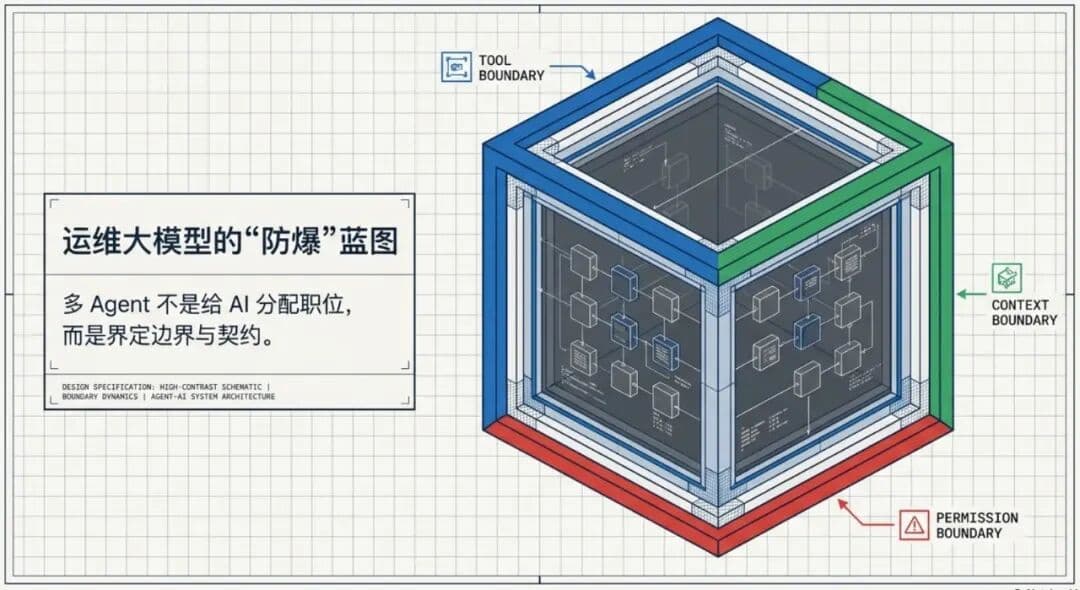
先简单介绍这三个边界在界定什么:
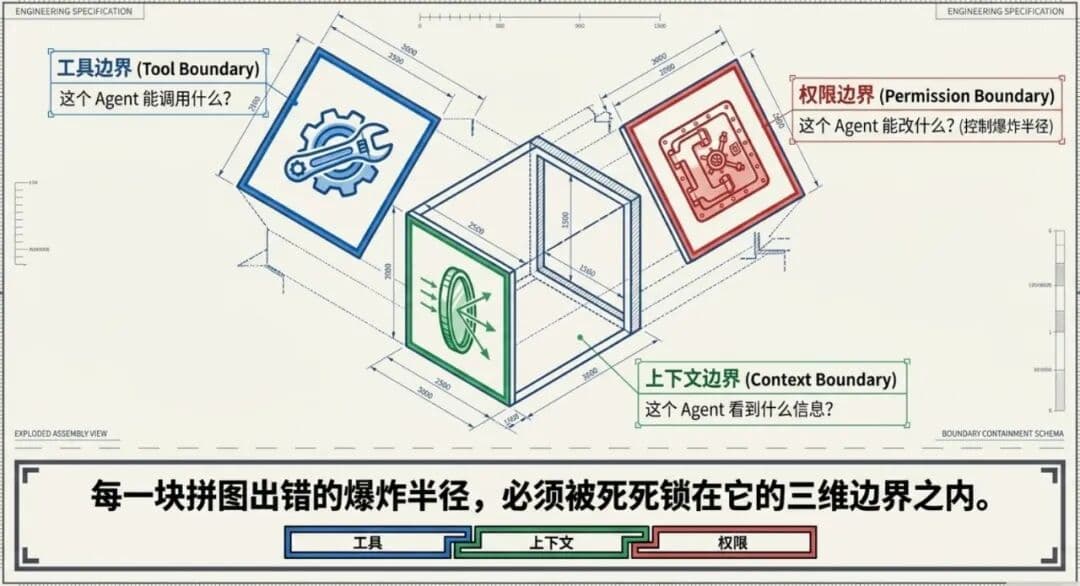
- 工具边界指的是我们在设计 Agent 时要界定的是”这个 Agent 能调用什么”。因为一个 Agent 的工具集决定了它能接触什么系统、能执行什么操作。
- 上下文边界界定的是”这个 Agent 看到什么信息”。所以 Agent 设计时你定义的 Agent 的 context 里可以装什么数据、不装什么数据,就决定了它的推理质量会不会被无关信息干扰。
- 权限边界界定的是”这个 Agent 能改什么”。设计 Agent 时我们可以通过定义 Agent 能写入什么、不能写入什么从而决定它出错的爆炸半径。
基于这些边界,我们在设计一支能在生产环境排查故障、执行修复、沉淀经验的运维 Agent Team时,你不会只设一个"排障 Agent",而是可以沿三条边界去逐一拆解:
正确的拆分方法:先看场景,再看角色,最后用边界塑造
那工具、上下文、权限这三个维度怎么用?不是说按这三个维度分就对了,你直接套这三个维度,你会发现还是不知道从哪下手。
正确的顺序是反过来的。先不看维度,先看场景。
第一步:把运维的日常场景摊开。
一段完整的排障链路里,到底发生了什么?把它拆开来看:
发现问题(告警响了)→ 采集现场(搜集变更、指标、trace、log等)→ 故障定界(对比基线、查知识库有没有类似案例或找到合适的人解决)→ 制定临时恢复方案(重启还是扩容)→ 执行修复(动手改)→ 验证恢复(确认服务正常)→ 根因定位(代码级别找到问题) → 沉淀经验(把处理经验写进知识库)
你不用一次性全自动化,但你得先把它梳理出来,因为这张场景地图是设计 Agent 团队的起点。
第二步:从场景里长出角色。
现在看这张地图,你会发现不同场景需要的能力天然是两类:
一类是拿数据和动手改——采集现场、执行修复。需要 SSH、需要 Prometheus、需要云 API、需要执行命令。
一类是动脑子和写下来——分析定位、沉淀经验。需要读结构化数据、需要推理、需要查知识图谱、需要写知识库。
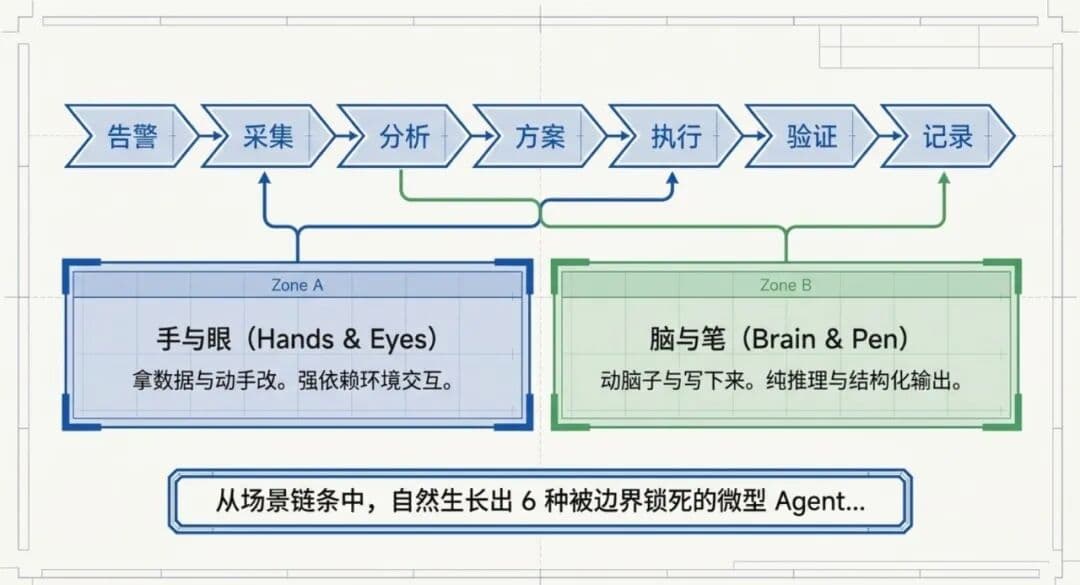
到这里,角色轮廓已经出来了:一个采集,一个分析,一个执行,一个知识写入。再加一个调度——它不干具体活,只在场景之间做决策,比如在每一个该采集、该分析、该执行修复、该记录的时刻做好拍板。
第三步:用三个边界把每个角色塑造立体。
角色有了,现在才轮到工具、上下文、权限。对每个角色,逐个回答三个问题:
- 能拿什么工具?(工具边界)
- Context 里能装什么?(上下文边界)
- 能改什么、不能改什么?(权限边界)
以"采集"角色为例。它的工具集里装的是 SSH、Prometheus、云 API——但全是只读的。它没有重启命令,没有写权限。不是"提醒它不要改",是根本没有那个工具。它的 context 可以装原始 SSH 输出、Prometheus 指标这些脏数据,数据量大没关系,只有它会看到。它的输出写成结构化文件,不进"分析"角色的 context。
以"知识写入"角色为例。它有知识库写入的工具。但它没有 SSH、没有重启命令。它的 context 只收分析角色的结构化结论——根因、方案——不需要碰任何原始采集数据。它能改的是知识库,不能改的是基础设施。出错了最多写错一条经验,不会把生产环境搞挂。
每个角色都是这三个问题过一遍。三刀切完,你得到的不再是一个"什么都能做"的全能 Agent,而是一组各自只有一块拼图的 Agent。每一块拼图出错的爆炸半径被锁在它的边界之内。
案例:Claude Code 自身的 Agent 设计
上面的三刀切法听起来还是没有画面感吗?我们可以再看看你每天都在用的 Claude Code,内部就是按这个逻辑设计的。
先想一个问题:如果让一个传统软件团队来设计 Claude Code 的 Agent,他们会怎么干?很可能照搬团队的组织架构——一个"前端 Agent"管 UI 代码、一个"后端 Agent"管 API、一个"DBA Agent"管数据库 schema。按技术栈分工,清清爽爽。
但 Claude Code 一个都没这么干。它的 Agent 没有一个按技术栈命名,全是按任务阶段的能力需求来拆:
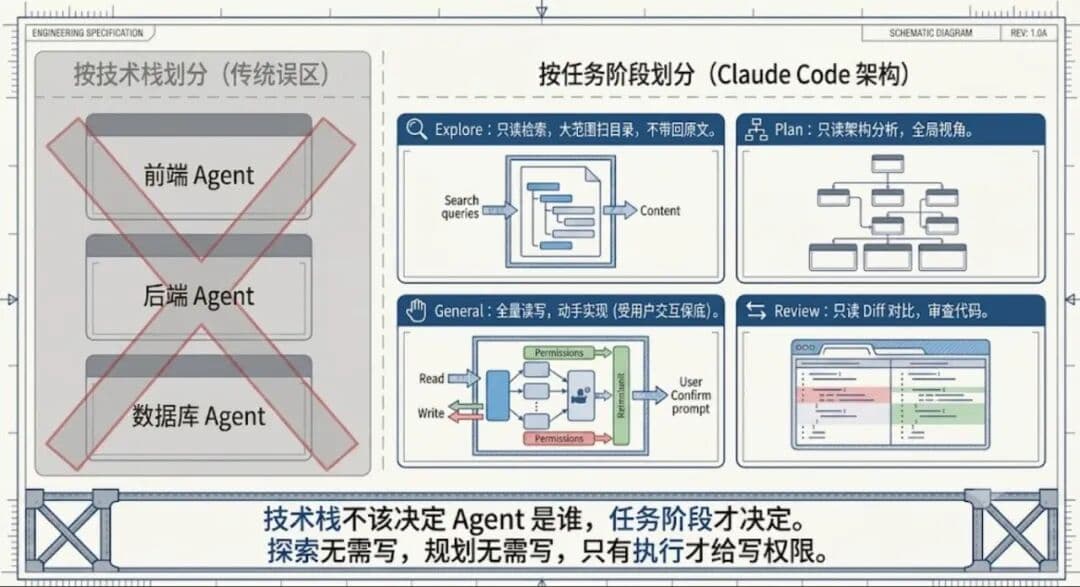
其中关键的还有:
没有一个叫"前端 Agent"或"后端 Agent"。 同一个 bug 的修复链路是:Explore 定位代码 → Plan 设计方案 → General-purpose 改代码 → code-reviewer 审查。四个 Agent 按阶段上场,而不是"这个 bug 在前端就派前端 Agent,在后端就派后端 Agent"。技术栈不该决定 Agent 是谁,任务阶段才决定。
Explore 不是"只读版 General-purpose"。 它的上下文边界也和 General-purpose 不同:Explore 扫大量文件后只提取结论返回,而不是把所有文件内容堆进上下文。这是上下文边界在起作用,使得"看到的信息"和"带回的信息"是两回事。
Plan 和 code-reviewer 都没有写文件的工具。 不是通过prompt去约束"设计方案阶段别急着写代码",而是Agent根本没有写的权限。因为工具边界和权限边界在同时生效,从而约束了Agent不能想就能写。
General-purpose 有全部工具,为什么还敢给它? 因为调用 General-purpose 的场景(用户直接发指令)本身就是交互式的,每一步操作用户都显性看得到,出问题随时打断。权限边界的"大"被交互模式兜底了。
小结:Claude Code 没有按技术栈分 Agent,它按任务阶段的能力需求分。探索阶段不需要写,规划阶段不需要写,审查阶段不需要写,只有执行阶段才给写——阶段决定角色,角色决定边界。
运维 Agent 角色设计思考
那运维场景呢?角色不一样,但拆分的逻辑完全一致。
回到前面摊开的那张场景地图。
发现问题 → 采集现场 → 故障定界 → 制定方案 → 执行修复 → 验证恢复 → 根因分析 → 沉淀经验。
八个场景,每个场景需要的能力边界天然不同。下面就是在实践中按这个逻辑推演出来的六个角色:
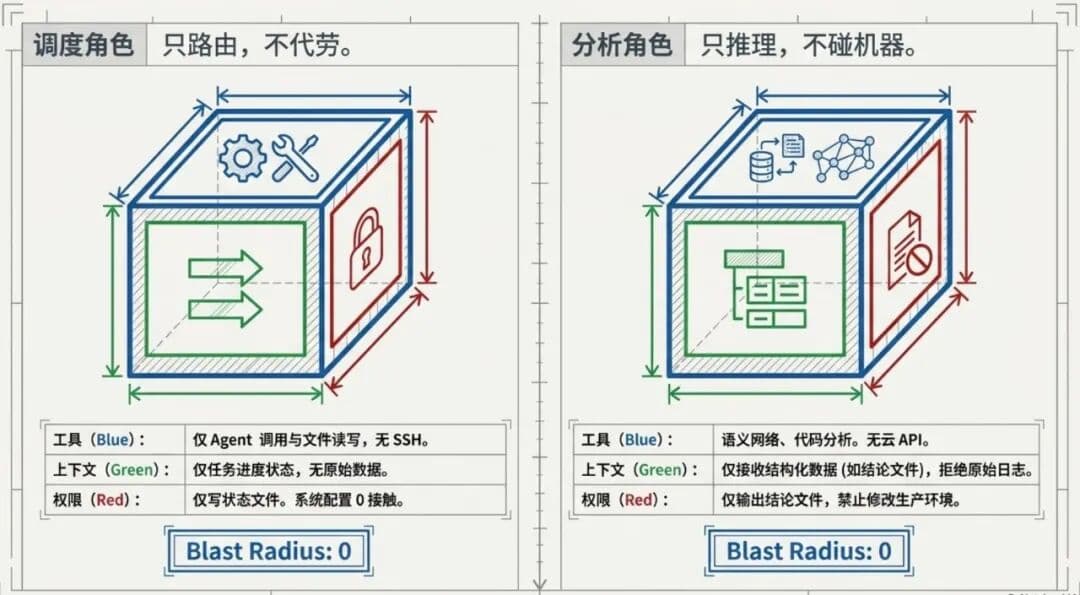
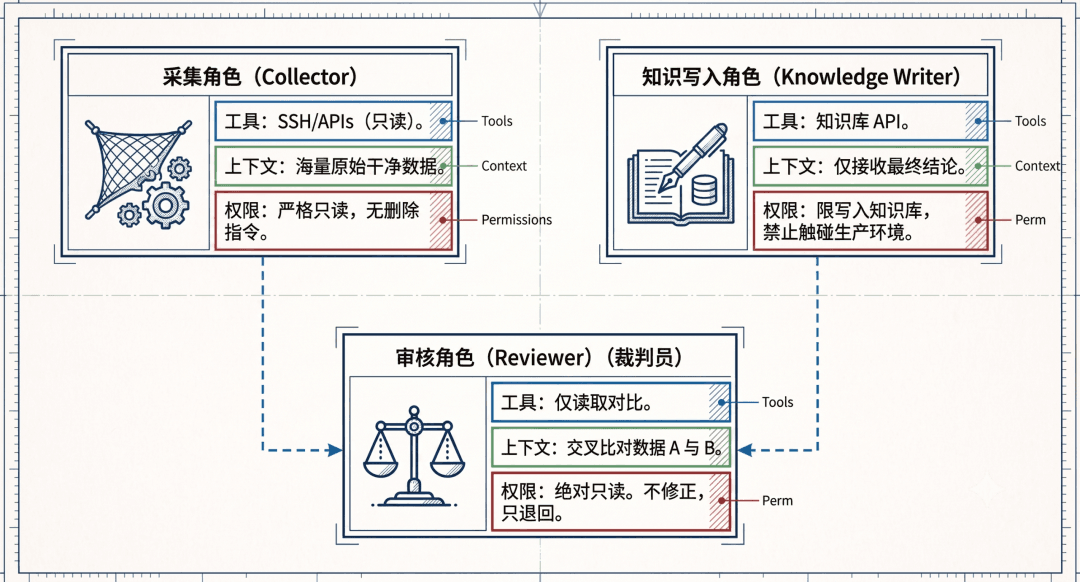
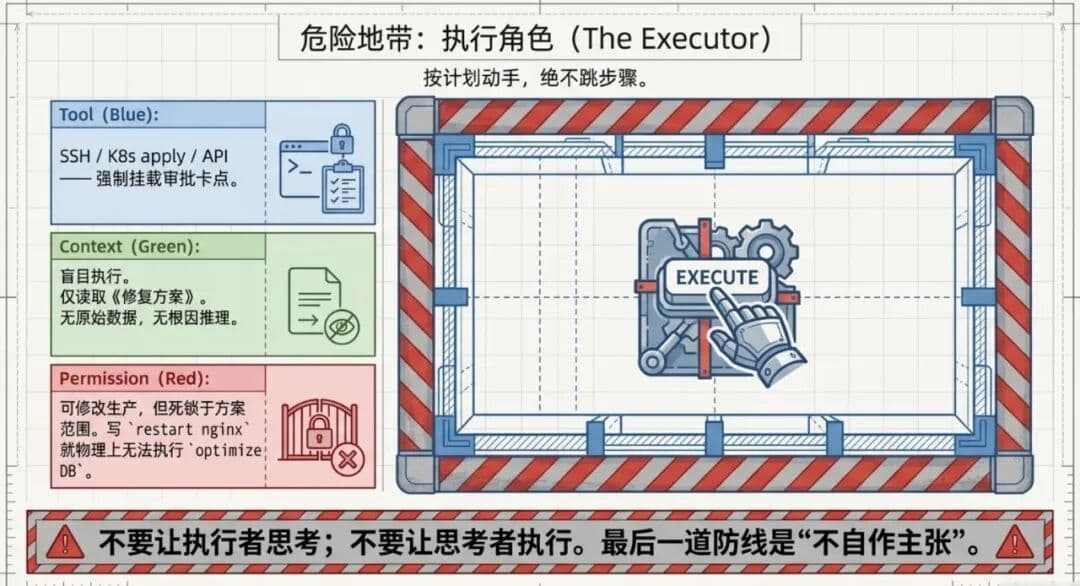
调度角色。只判断,不执行。
调度对应场景链里的"发现问题,决定下一步"。它不需要碰任何机器,也不需要看原始数据。三条边界这样切:
- 工具:Agent 调用、文件读写 和 目录探索。没有 SSH,没有 Prometheus,没有任何 MCP 工具。
- Context:只看当前环境里有哪些 Agent、各有什么 Skill、任务进度到哪了。原始采集数据一律不装。
- 权限:只能写任务状态文件。系统配置不改,语义网络不写。
切完的效果:调度角色想自己分析都不行,因为没有分析工具。它的边界决定了它只能路由,不能代劳。
采集角色。只拿数据,不改东西。
采集对应场景链里的"SSH 上去看进程、日志、连接数"。需要接触生产环境,但只需要看,不需要改。
- 工具:SSH、K8s API、Prometheus、云厂商 API 等数据采集工具,全部只读。
kubectl get可以有,但kubectl delete不在工具列表里。这不是靠 prompt 提醒Agent别做删除的危险动作,而是根本没删除的工具。 - Context:可以装原始 SSH 输出、进程列表、指标时序。数据量大没关系,只有它自己看到。而Agent的输出会写成结构化文件,其他 Agent 只拿文件路径,不拿采集Agent数据量巨大的文件内容。
- 权限:只读。能看生产环境,有限的写操作,不能直接删除任何东西。
切完的结果:采集角色的爆炸半径锁死在有限的读写操作中。
分析角色。只推理,不碰机器。
分析对应场景链里的"对比基线、查知识库、定位根因"。需要推理能力,但不需要碰生产环境,更不需要把原始数据全量灌进 context。
- 工具:语义网络查询、代码分析、推理工具。没有 SSH,没有重启命令,没有云 API。
- Context:只装结构化结论。比如"5 台机器中 3 台的连接数超过阈值,依据文件 A 第 3 至 5 行",而不是 500 行的 TCP dump。采集的巨大数据量带来的噪音被上下文边界挡在外面。
- 权限:能读采集文件和知识库,不能改任何生产配置。分析结论可以写入文件供下游消费。
切完的结果:分析角色能判断出"需要重启 Nginx",但它自己没能力去重启。结论和执行分属两个角色。
审核角色。只对照,不修正。
审核对应场景链里的"修之前再看一眼,证据链能不能对上"。它不需要新数据,不需要新工具,只需要对比已有数据的一致性。
在我们Agent Team的设计和测试中审核的角色相当重要,审核角色具有一票否决权。它的本质其实是用token换准确性。
- 工具:只读文件、语义网络查询。没有 SSH,没有执行权限,没有写权限。
- Context:只装两份文件。一份分析角色的结论,一份采集角色的原始数据。不做新推理,只做对比。
- 权限:只读。不能修改结论,不能自己补证据,不能重新采集数据。发现问题只能退回,不能修正。
切完的结果:审核角色永远不可能帮分析角色改结论。它没有写的工具。运动员和裁判被权限边界彻底隔开。
执行角色。按计划动手,不跳步骤。
执行对应场景链里的"动手修复、重启服务、变更配置"。这是唯一需要大量写权限的角色,也是爆炸半径最大的角色,所以边界切得最紧。
- 工具:SSH 执行命令、K8s apply、云厂商变更 API。但这些工具前面挂了一层审批检查。涉及重启、删除、变更生产配置时,审批不通过工具调用直接拒绝。
- Context:只读分析角色产出的修复方案和采集角色的环境快照。不读原始数据,不自己推理根因。它不需要懂了再改,它只需要严格按方案改。
- 权限:能改生产环境,但只能改修复方案中指定的操作。方案里写 restart nginx 就只 restart nginx,不能顺手 optimize 一下数据库。不自作主张是权限边界的最后一道防线。
切完的结果:执行角色是唯一能大量操作生产环境的角色,但它的破坏半径被三样东西锁住。上游的分析方案它不能改,审批卡点它绕不过,操作范围被方案严格绑定。
知识写入角色。只写经验,不碰配置。
知识写入对应场景链里的"把根因和修复方案写进知识库,下次同类问题直接匹配"。需要写权限,但写的对象是知识库,不是生产环境。
- 工具:知识库写入工具。没有 SSH,没有重启命令,没有云 API。
- Context:只读分析角色的根因结论和执行角色的修复结果。不读原始采集数据,不读推理中间过程。
- 权限:能写知识库的 RootCause、Solution、Experience 三类实体。不能改基础设施配置。它有知识库的键,没有生产环境的键。
切完的结果:知识写入角色出错了最多写错一条经验记录。生产环境不受影响,爆炸半径锁在知识库之内。
六个角色,每个角色把三个问题过一遍之后,你得到的不是一个什么都能做的全能 Agent,而是一组各自只有一块拼图的 Agent,每一块拼图出错的爆炸半径被锁在它的边界之内。
三刀切法不是理论,对每一个角色,逐个回答能拿什么工具、context 里装什么、能改什么不能改什么,答案自然就出来了。
角色也不是一次设计完的,是在一次次跑任务中长出来的。先上调度、采集、分析三个,跑通了再看缺什么。比如结论没被校验就加审核,排障完了没人记录就加知识写入,分析说重启但没人动手就加执行,缺哪个补哪个。
继续往下看的话,只有角色还不够,怎么让它们协作?
方向2: Runbook — 用结构化约束让长任务可恢复可追溯
Runbook 是什么,跟 Claude 厂商提出的 Skill、Workflow 这些机制有何异同?
Runbook 是把运维经验固化为结构化工作流的方式。它约束 Agent 的行为不是靠 prompt 建议"你应该按步骤来",是用可执行的契约定义每一步的输入、输出、检查点和失败处理。具体我们可以看:
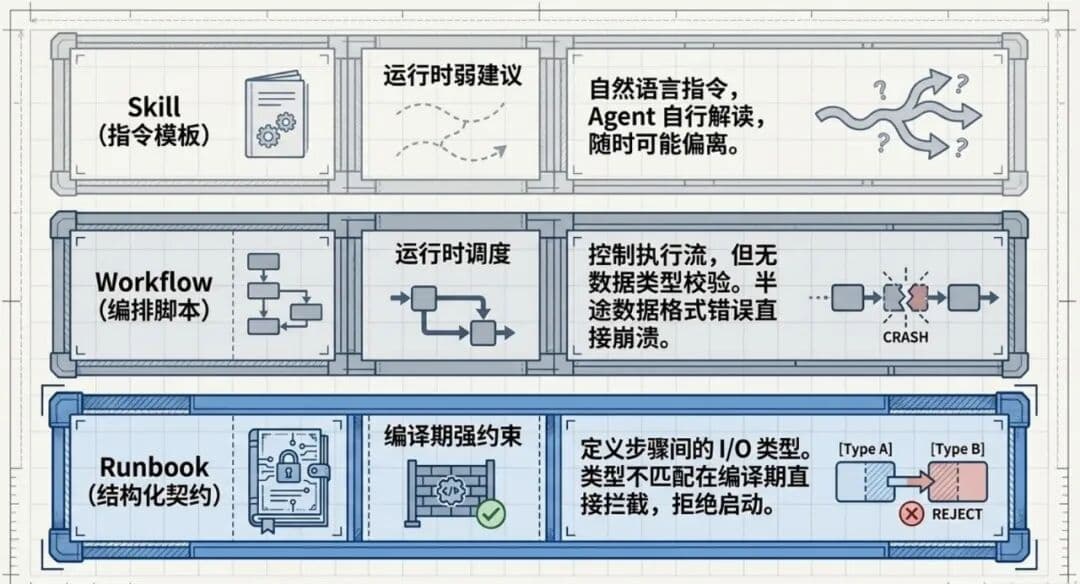
这三者的区别不在有没有Agent的执行步骤,而是在对Agent的约束发生在哪个阶段:
- Skill 是建议Agent"遇到这个场景你可以这么做",建议是可以不听的;
- Workflow 是编排调度 Agent 按什么顺序跑,但Agent具体执行是不可控的;
- Runbook 是Agent协作的契约,如果协作步骤之间的输入输出类型对不上,编译期就拒绝,根本不会跑到一半才发现问题。
如何设计运维 runbook?
四个设计概念:
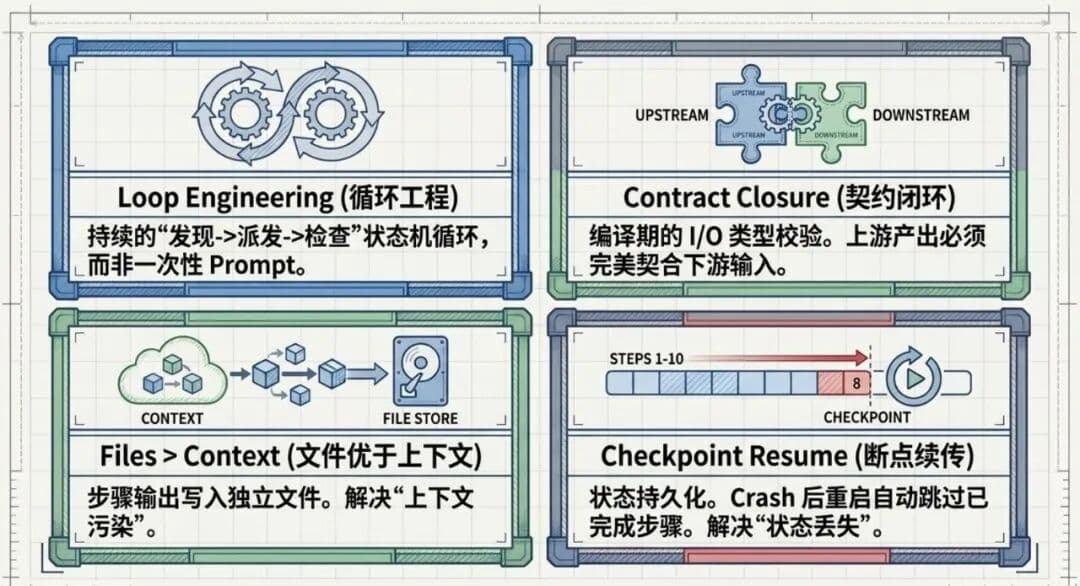
- Loop Engineering — 不是一次性 prompt,是循环。 你写巡检脚本不会只跑一次——查监控 → 发现异常 → 定位 → 决定扩不扩容 → 扩完再查监控确认。Runbook 的设计就是这种循环:"找到工作 → 派发 Agent → 检查结果 → 决定下一步"。不是"帮我排个障"的一锤子买卖,是一个会自己判断"下一步干什么"的系统。
- Contract Closure — 前置契约校验。 Ansible playbook 里上一个 task 的 register 变量类型和下一个 task 的 when 条件不匹配,语法检查阶段就报错——不会跑到一半才炸。Runbook 同理:采集步骤的输出结构必须匹配分析步骤的输入结构。不匹配在编译期就拒绝,不在运行时爆炸。
- Files over Context — 文件系统是 Agent 的外部记忆。 你排查故障不会把所有日志全打开堆在屏幕上。你会 grep 关键字段写到一个文件里,对着文件分析。Runbook 的每一步输出写入独立文件,不共用 context。回到根因一和四:文件不会被 context 窗口覆盖,crash 后文件还在。
- Checkpoint Resume — 从断点继续,不从头开始。 长脚本跑到第 8 步挂了,你不会从头跑一遍——你修好第 8 步,从第 8 步继续。Runbook 的每一步完成时写入 checkpoint,crash 后重启自动跳过已完成步骤。回到根因四:代理的不是"模型不 crash",是"crash 了也不用从头来"。
这四个概念怎么落地?
Runbook 落地:从 Prompt 到可执行工作流
Runbook 的理念不复杂,简单来说就是把运维经验写成结构化的步骤,而不是塞进 prompt。但落地时几个实践细节值得注意:
步骤粒度的把控: 单个步骤应该是一个"做完有明确产出物"的原子操作,比如"采集 5 台机器的连接数"是一个步骤,"分析连接数异常"是下一个。不要一个步骤里塞三件事,也不要把一个简单查询拆成五个步骤。
比如把"SSH 登录、查进程、查连接数、查磁盘、重启服务、验证恢复"全塞进一个 step。步骤名叫 fix_server,实际做了六件互不相关的事——哪件失败了你都不知道,checkpoint 也无从恢复。
编译期校验: 步骤之间的输入输出在构建时做契约校验,比如采集步骤的 output schema 必须匹配后续分析步骤的 input schema。不匹配则立即在编译时就报错,不给运行时留隐患。
失败处理: 工作流的每个步骤都需要声明重试次数和超时时间。超时或重试耗尽后走 fallback,比如不是静默跳过,而是是写一条"此步骤未完成"的标记,让下游步骤决定要不要继续。
人机确认节点: 不是每个步骤都需要人审,不然 AI Agent 无法在一些简单可控的任务下自助。我们可以只在三种情况下插入确认:权限边界跨越(从只读进入写操作)、置信度不足(AI 推理置信度低于阈值)、影响范围不可逆(删除、重启、变更生产配置)。
一个完整的 Runbook 长什么样
下面是一个真实的 runbook.yaml 示例——SSH 登录服务器、重启 Nginx、验证恢复。32 行,不复杂:
name: restart-nginx                                  # ← runbook 名称,唯一标识
description: SSH into a server, restart Nginx, and verify it's back up

input_params:                                        # ← 对外暴露的参数
- name: host
    type: string
    required: true

steps:                                               # ← 步骤 = DAG,不是顺序列表
- id: restart
    type: agent                                      # ← 每个 step 可指定不同执行方式
    depends_on: []                                   # ← 无依赖 = 第一步
    description: SSH in and restart Nginx
    prompt: SSH into {host} and run systemctl restart nginx
    output:                                          # ← 输出写入文件,不留在 context
      - file: restart_result.json
        schema: schemas/restart.schema.json          # ← Contract Closure:编译期校验

- id: verify
    type: agent                                      # ← 独立 Agent,不共用 context
    depends_on: [restart]                            # ← 依赖 restart 完成后才执行
    description: Verify Nginx is healthy
    prompt: curl http://{host}/health and check the status code
    input:                                            # ← 输入声明:从哪个步骤读什么
      - schema: schemas/restart.schema.json
        from_step: restart
        file: restart_result.json
    output:
      - file: verify_result.json
        schema: schemas/verify.schema.json
逐行看几个关键设计:
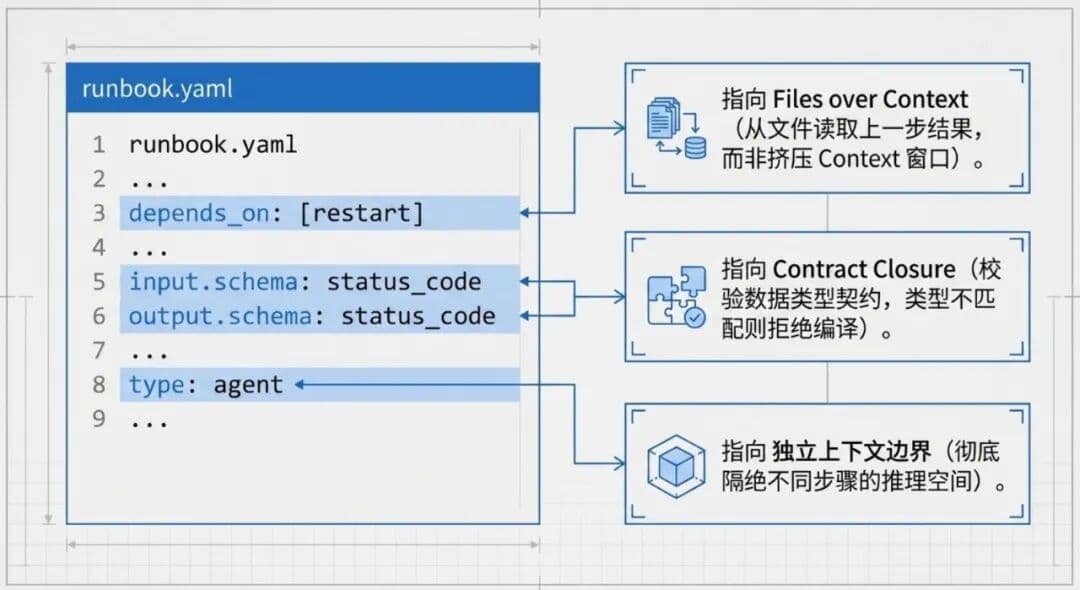
depends_on — Files over Context。 restart 的输出写到 restart_result.json,verify 从文件读,而不是把 restart 的 5 台机器 SSH 输出全塞进同一个 context。回到前面说的根因一和四:文件不会被窗口淹没,crash 后文件还在。
input.schema + output.schema — Contract Closure。 restart 的输出结构必须匹配 verify 的输入结构。如果 restart 输出了一个 status_code(integer),但 verify 期望 status(string)——编译期就报错,不会跑到一半才炸。写过 Ansible playbook 的人秒懂这个痛。
type: agent — 独立上下文。 restart 和 verify 是两个独立 Agent,各自有自己的 context 窗口。restart 的采集信息不会污染 verify 的推理空间。这就是前面聊的"三刀切法"里上下文边界的落地。
开箱即用
刚才的 restart-nginx 只有 2 步,适合简单操作。更复杂的场景,比如全量巡检发现故障、逐个人工审批修复、修复后再验证等等。我们在实践中把它们做成了一个开源工具。它用 YAML 定义工作流(步骤、依赖、输入输出契约),编译期做契约闭环校验,运行时写入 checkpoint。步骤类型支持内联 prompt、派发子 Agent、shell 脚本、并行执行、条件分支和循环。你可以直接把它集成到任何 Claude Agent 的工作流里。
repo 里有一个 host-health-loop 示例,结构如下:
inspect(Ansible巡检扫全量主机)
  └─ fix_loop(循环直到无故障,最多10轮)
       ├─ select_issue(选最严重的一个故障)
       ├─ plan_action(Agent SSH 排查 → 写修复计划)
       ├─ approve(🛑 人工审批,approve/reject)
       ├─ execute(执行修复 + quality_check 校验)
       └─ re_inspect(再扫全量,验证+刷新故障列表)
  └─ generate_report(生成 HTML 排障报告)
更完整的「 巡检→排障→人机审批→修复→再巡检→出报告」 的 runbook 示例可以在 GitHub repo 里看到 → https://github.com/KnoxOps/agent-runbook
agent-runbook 是开源的,花 30 分钟装好工具、写一个你最熟的运维场景(比如服务健康巡检)、跑一次、看 checkpoint 恢复和契约校验是不是真的有用。这一个 runbook 跑通了,你心里就有数了。
后记
上一篇的文章讲了基于本体论建模构造的知识图谱让 Agent 理解环境,今天的分享内容是通过 Agent Team 设计和 Agent runbook 机制使得 Agent 可安全地长时间运行。后续还会跟大家继续分享数据采集、安全护栏等更多实践探索,也欢迎大家在评论区分享你的落地实践~