前言
最近几个同行沟通交流时发现大家用AI提效了很多,但是人也是一点没轻松,特别是借助通用大模型做运维总觉得隔着一层:
- 跟AI下达任务做需求澄清经常怕交代不清背景导致AI缺失上下文
- 推理过程经常是黑盒,执行类的事务无关大小必须一一审阅;
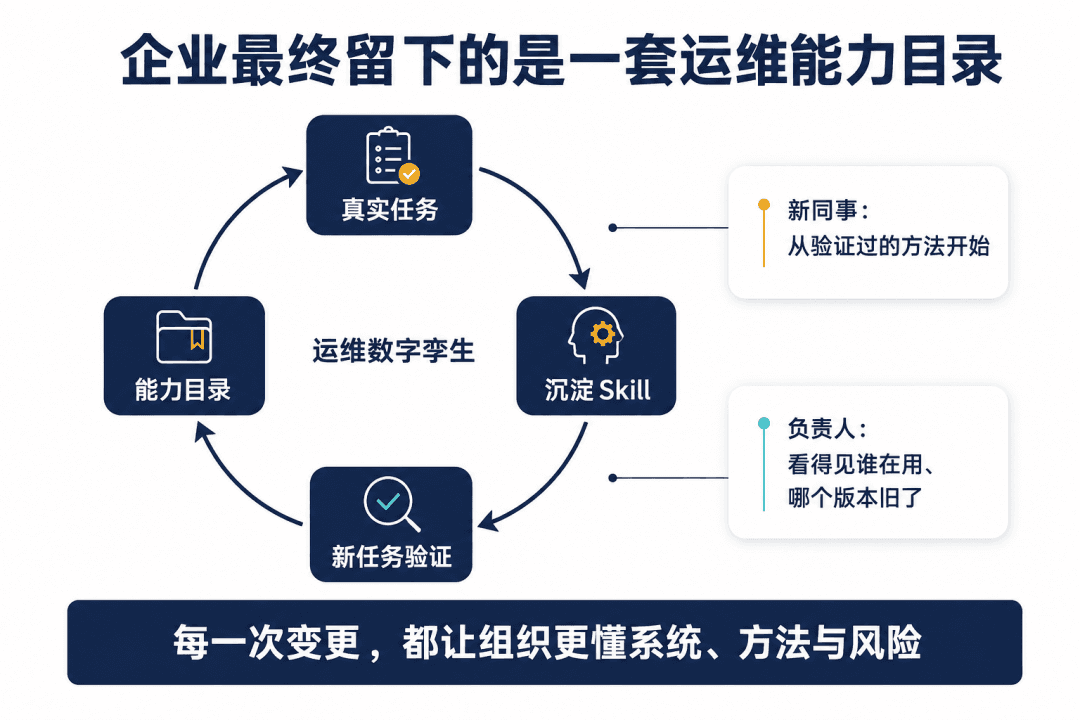
- AI Agent工作的过程和经验无法沉淀,整个 「人-AI Agent-生产环境」 之间缺乏一个闭环协作体系。
- 团队规模小,虽然可以借助AI快速搭建运维工具,限于开发能力和精力被日常事务缠绕导致投入产出比低。
那在现有的基础上,怎么才能更好地用AI呢?如果说现在你用AI做运维就是带一个无法脱离你视野独立工作的应届毕业生,那你的课题就是如何让这个应届生可以在大多数情况下独立可靠的工作,必要时再找你汇报。那如何让应届生可以快速成长为专业SRE呢?
对生产环境的了如指掌 + 调度可用工具 + 风险合规 + 经验判断 = ?
我想答案可能是一个基于本体论构建的运维知识图谱,我将结合团队在运维智能体方向的实践,聊聊本体论与智能体相结合的搭建思路。如果你最近也在运维AI落地困扰与探索,期待你和我一起讨论碰撞更多的火花。
本体论是什么?
分享落地实践之前,我们先简单谈谈本体论是什么。
本体论(Ontology)最初源自哲学领域,用于系统性地描述事物、属性与它们之间关系的形式化结构。随着商业对数据语义需求的提升,本体论成为企业实现数据可信语义层、构建可靠数据模型的关键方法。我们可以用CMDB的建模快速理解一下本体论的内容:
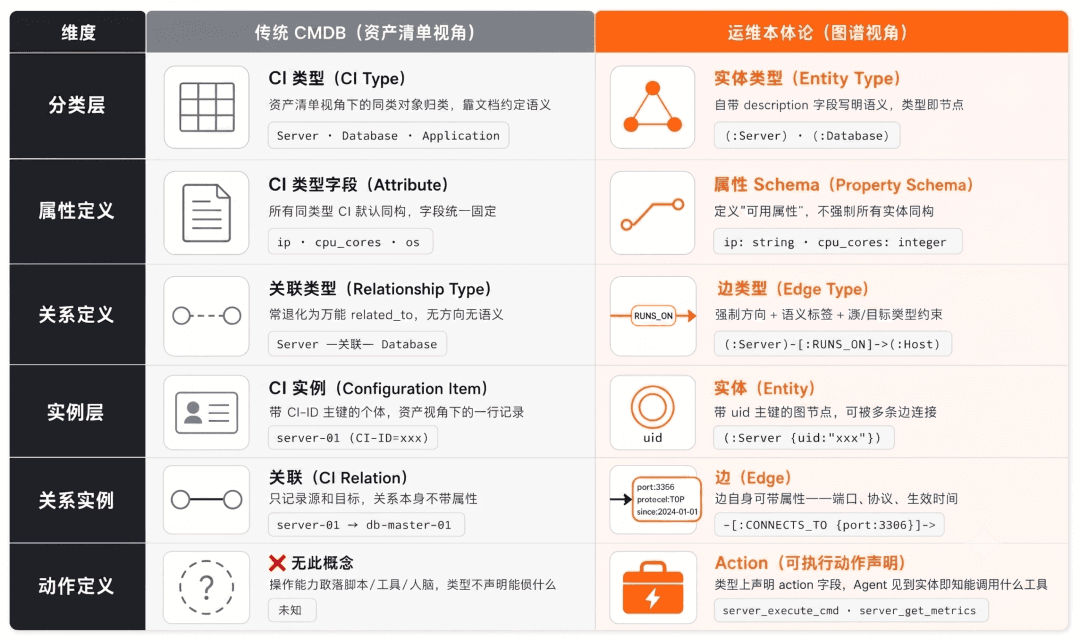
企业就是通过这样本体建模构建数据的统一语言。那这和过去CMDB建模有何不同?这不是新瓶装旧酒吗?
建模哲学的差异
首先他们的建模哲学不一样:
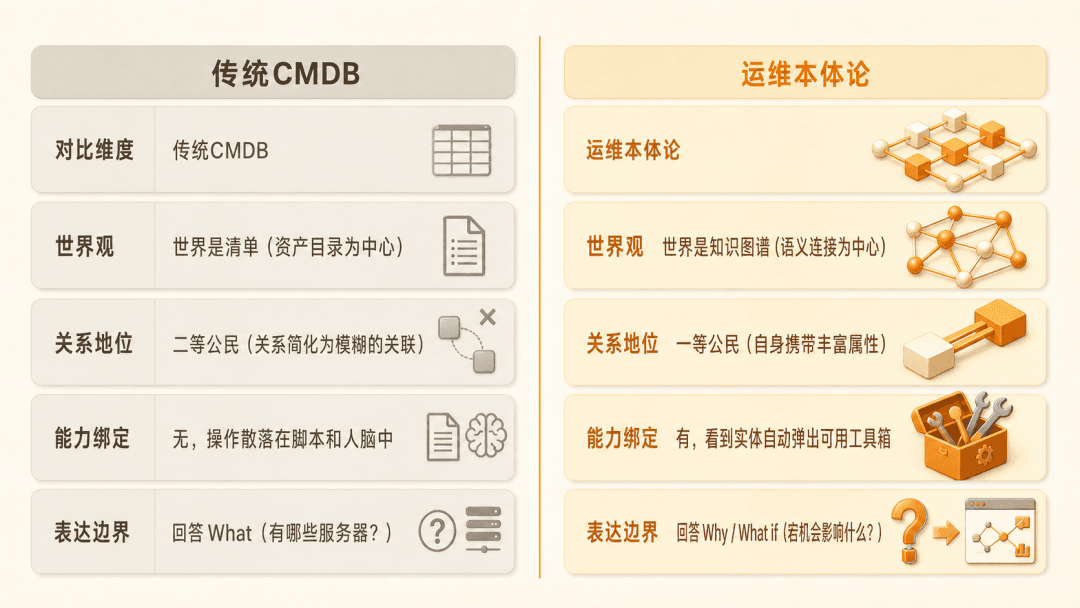
对 AI 的友好度
再者他们对AI的友好度不一样:
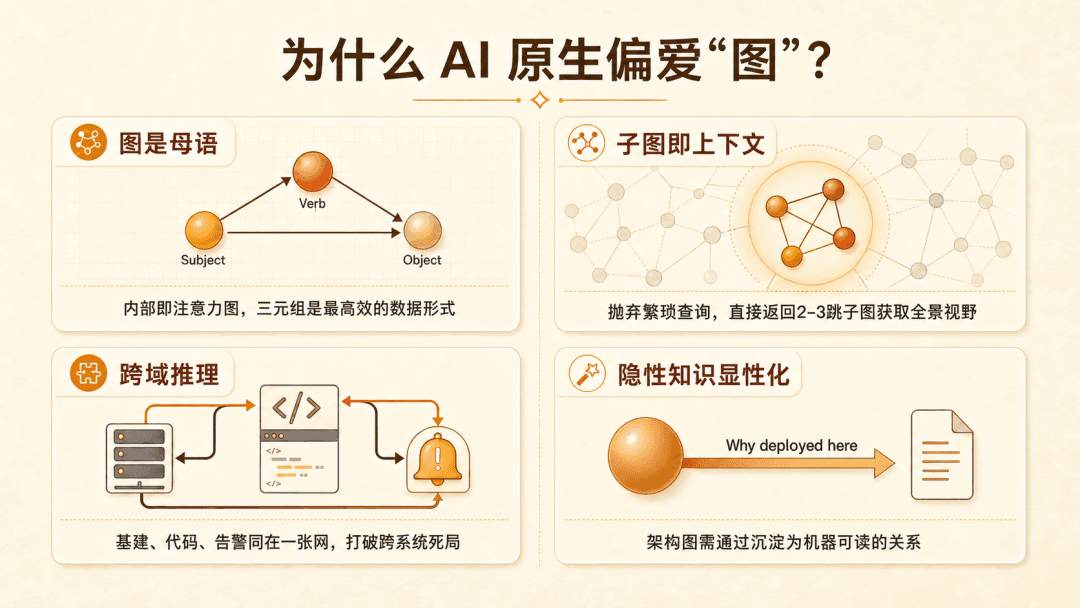
也就是说,本体论建模构建的知识图谱是AI天然可读的一本书,而这本书可描绘企业IT运维所需的统一世界观,这时AI就可以了解你的生产环境现状,知道企业内部积累的运维经验,知道IT资源在什么情况下有什么直接可用的安全合规工具。
回到刚开始的问题,这本书是不是解答如何帮助你的数字员工从应届生向专业SRE迈进?
为什么现在需要本体论?
其实无论是CMDB还本体论,企业运维时所需的"真理来源"、"金表"还是"语义层",这里的核心诉求始终是:让任何人/Agent都能准确、高效查询并获得反映真实业务运作的运维数据。
本体论作为概念存在已久,为何在AI爆发时代被重提。因为人类的生产活动中新增了AI Agent,在运维行业来细说以前是人直接使用运维工具去处理生产环境,而现在是人让AI参与到生产环境的维护工作中,那这里的关系可能就是 「人-AI-工具-生产环境」,走AI原生的路线的话就是 「人-AI-生产环境」。
也就是说过去不需要本体论,是因为判断和具体行动是人类去执行的。人类靠存在于脑子里的系统架构、运维经验和散落在各大工具平台实时查询得到的数据在系统之外做出决策,然后在通过itsm等流程实现可审计可追溯等合规诉求。
但是在AI浪潮下,你应该已经意识到大部分工作已经可以外包给AI Agent了,问题是你如何才放心把这部分工作交接给Agent?那就是你信任Agent可以比你更快更好的解决运维问题。
信任的首要条件是降低AI幻觉对决策的干扰;再者就是Agent真的可以深刻理解运维领域的专业名词、生产环境现状、可推理可反馈的工作准则。
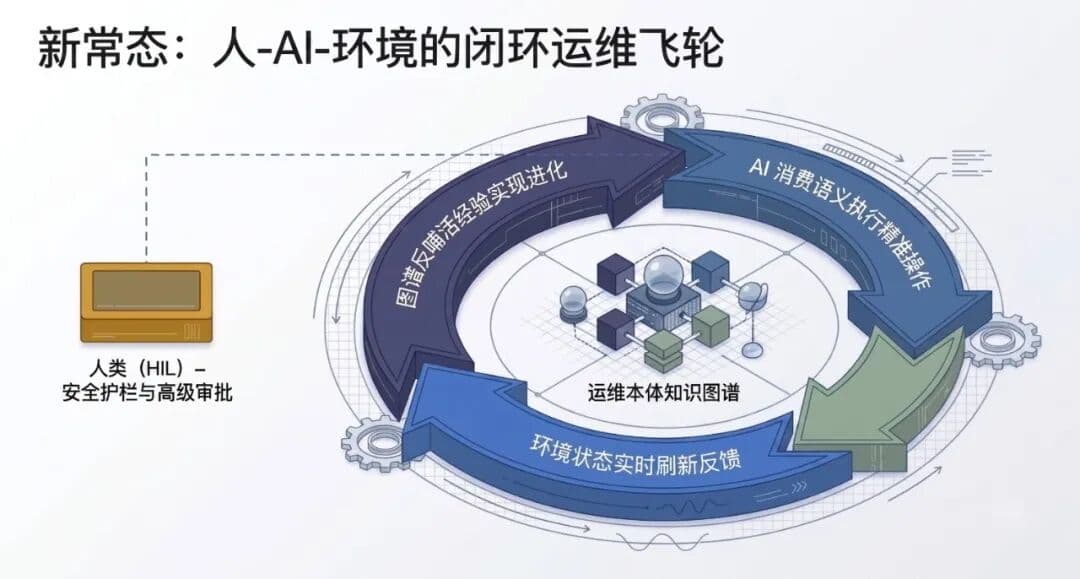
那如何达成呢?本体论和AI Agent他们之间是黄金搭档可以相辅相成——本体论的建模约束和AI天然可读的统一世界观带来运维所需的准确性和稳定性,而AI Agent对本体论构建的数据在语义层进行消费与反哺进而盘活了本体论。一方是数据需要消费才能盘活,另一方是企业想用好AI Agent需要结构性数据。
本体论在AI大模型爆发之前一直不温不火,只在知识管理、风控这些少数领域有声音。不是它们没用,是没有一个足够强的消费者去持续驱动它。AI大模型恰好就是这个消费者——本体论建模把环境信息结构化之后,大模型的AIGC生成从"泛化推测"变成了"有据可依";大模型的意图识别和复杂推理能力,又能在本体构建的关系网络上跑出传统规则引擎做不出的推理路径。
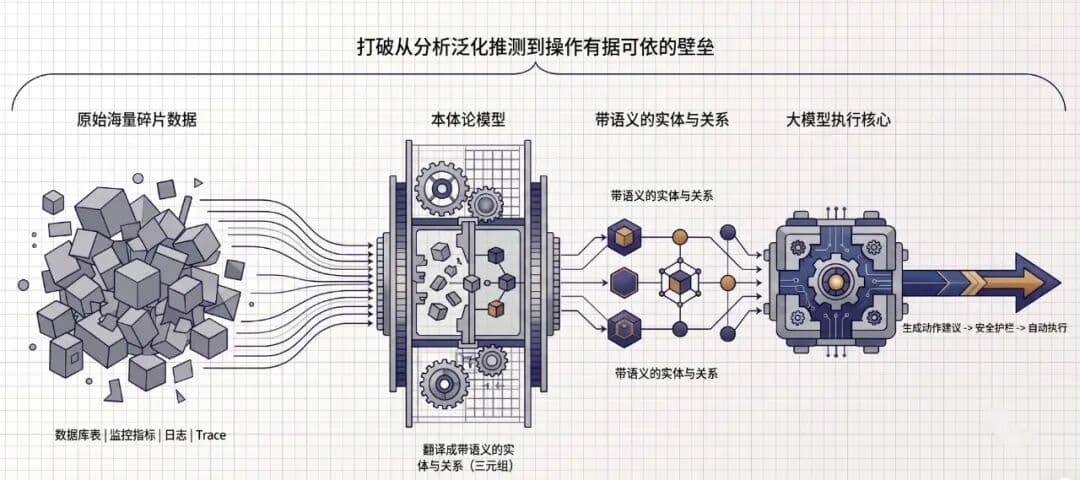
简单理解就是:本体模型是传统数据模型和AI大模型之间的语义翻译层。它一边把数据库表、监控指标、日志这些原始数据翻译成带语义的实体和关系,另一边把这些实体关系以三元组的形式喂给大模型做推理和决策。
本体论在运维领域如何落地
过去很多企业费时费钱建设本体论几乎都失败告终,导致企业对本体论望而却步。这里失败的第一个门槛就建模复杂度,那建模设计的第一步如何解决?我们团队的实践是直接将过去10年服务各大行业的专业运维经验沉淀下来,输出了一套运维本体论模型,其他运维团队可以直接拿来即用。
内置建模
这套模型包含 40 多种实体类型,分多个维度覆盖运维全景。业务层是入口——BusinessIsland(业务群岛)把相关的服务聚合在一起,比如"电商系统"下面挂了订单服务、支付服务、用户服务,对应的是"这个故障影响的是哪块业务"的判断。
但业务聚类只是模型的一个切面,Agent 真正要排查问题时,还需要沿多条关系路径交叉定位:
- 部署路径:BusinessIsland → Environment → Service → ArtifactInst(部署实例)→ OS → CloudVM。回答"这个服务跑在哪台机器上"
- 调用路径:Service → CALLS → Service。回答"这个服务调用了哪些下游服务、被哪些上游调用"——东西向流量。比如排查"订单服务慢了",除了看它自身和它依赖的数据库,还要看它调用的下游服务(库存服务、支付服务)是否有延迟放大
- 流量路径:Domain → LoadBalancer → Service。回答"用户请求从哪个域名进来、经过哪个 LB 落到哪个服务"
- 依赖路径:Service → CloudRDS / CloudCache / CloudSecurityGroup。回答"这个服务依赖了哪些数据库、缓存、安全策略"
多条路径交叉,Agent 才能做有依据的推理——比如"订单服务响应慢了",先沿流量路径确认是哪个入口进来的请求受影响,再沿调用路径排查上下游服务是否正常,沿部署路径追溯到具体 CloudVM,最后沿依赖路径检查关联的 CloudRDS 是否有慢查询。
模型的覆盖范围涵盖了当前主流的部署形态:传统 VM 和物理机(CloudVM、OS、PhysicalServer)、K8s 容器集群(K8sCluster、K8sNamespace、K8sWorkload)、云平台资源(CloudVPC、CloudSubnet、CloudRDS、CloudCache、LoadBalancer 等)。运维团队就不需要从零设计每种资源的建模方式,直接基于这套预定义类型即可表达自己的基础设施。
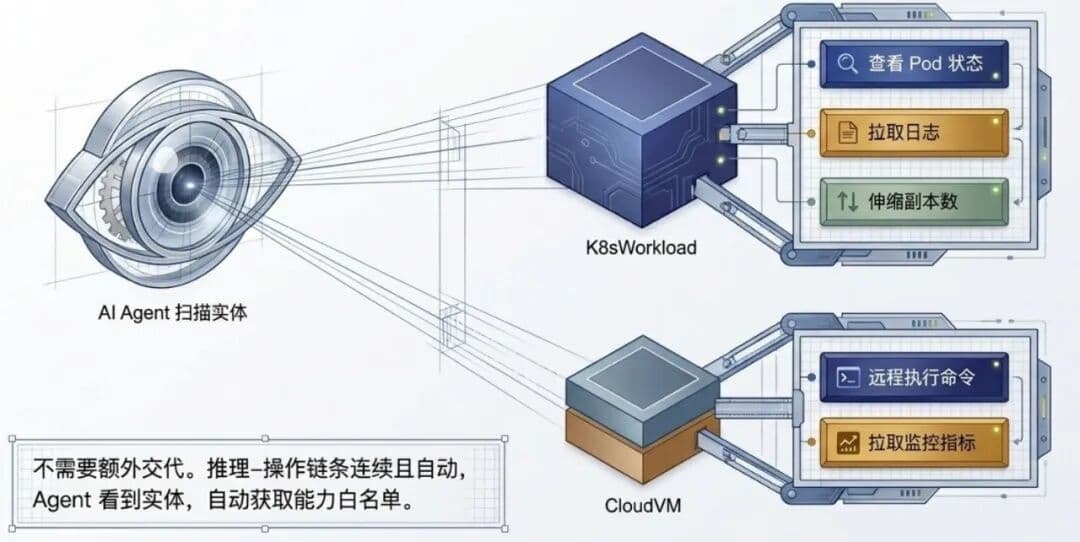
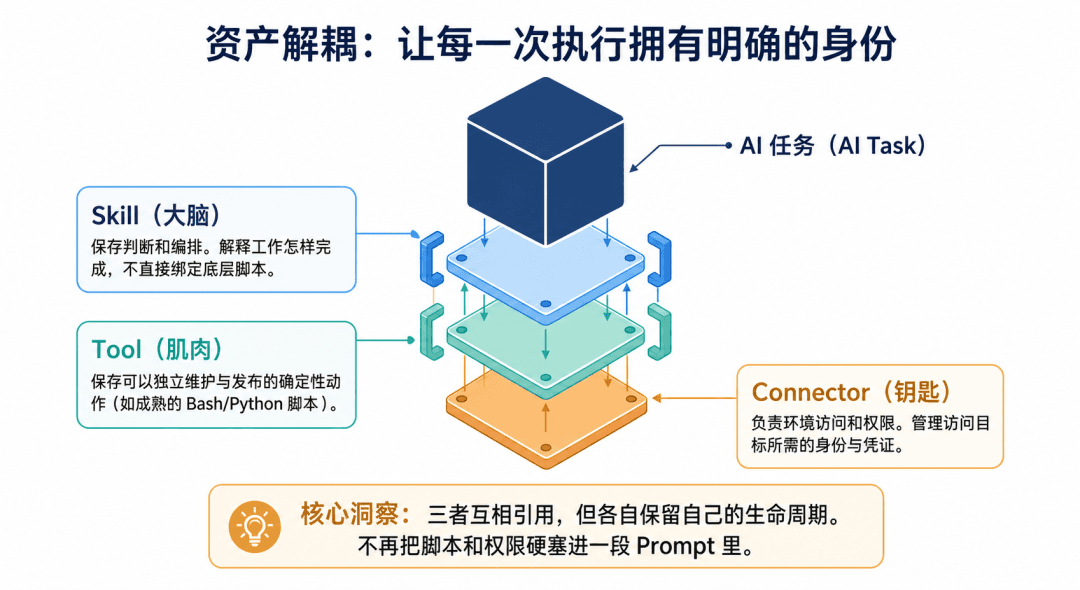
还有一个容易忽略的设计:本体论里每种实体类型都关联了可执行的操作能力。比如 CloudVM 关联了"远程执行命令"、"拉取监控指标"等操作;K8sWorkload 关联了"查看 Pod 状态"、"伸缩副本数"等操作。这些关联不是静态写在文档里的知识,而是实体的 Schema 定义和实际连接的工具集之间的映射——Agent 在排查过程中看到一个 CloudVM 实体,就知道能对它做什么、应该对它做什么,不需要人额外交代。
这在 RCA 场景下尤其关键:Agent 沿着关系路径从 Service 追溯到 CloudVM 之后,可以立即对目标机器执行诊断命令,整个推理-操作链条是连续的、自动的,不需要人在中间接力。
知识沉淀与反哺
CMDB 存的是"现在有什么"。本体论在同样的实体和关系上,还叠加了 RootCause、Solution、Experience 这些知识实体——每次故障排查、每次变更记录都在反哺图谱。下次类似问题出现,Agent 可以检索历史经验。CMDB 也有变更记录和工单关联,但它们和 CI 之间的关系是弱关联,不是图结构中一等公民的推理路径。
举个例子,假设运维同学在对话中发起"排查 order-api 响应慢":
第一次排查——Agent 沿依赖路径(order-api → DEPENDS_ON → mysql)定位到 RDS 连接数异常,对 RDS 执行实时诊断后确认是 order-api 的连接池 idle timeout 过长、连接不释放。诊断结论会被结构化写入图谱:
RootCause "连接池idle timeout配置过长导致连接泄漏"
  → CAUSED_BY → Service "order-api-prod"
  → AFFECTS  → Service "order-api-prod"

Solution "缩短idle timeout到合理阈值"
  { steps: [...], effectiveness: 0.95 }
写入后,类似告警再次出现时,Agent 可以先检索 order-api-prod 关联的历史 RootCause,直接验证"是不是又是连接泄漏"——从遍历式排查变成假设驱动的靶向验证,路径短得多。
这里大家最关心的问题:Agent 会不会无脑写入、把图谱污染成垃圾堆? 我们的实践是处理是三层质量门槛:
- 角色权限隔离——负责知识写入的 Agent 只能写 RootCause、Solution 这类知识实体,不能动基础设施实体;基础设施实体由采集 Agent 写,职责不交叉
- 写入前需证据链——根因结论必须挂载到具体的实体上(通过 CAUSED_BY 关联到 mysql 实体),不能写悬空的、无法追溯的经验
- 主观判断走 HIL——根因和方案这类需要人判断的结论,写入前会停下来请运维同学确认,不是 Agent 自己拍板入库
这三层保证进图谱的知识经验是"经过验证、可追溯、有人把关"的,而不是 Agent 推测一次就沉淀一条。
模型维护
除了直接可用的建模和持续的知识经验沉淀,我们还要考虑模型的扩展性和可维护性。
我们探索设计了核心实体类型的继承体系:建模时不需要为每种实体重复定义关系,基类决定了通用约束,扩展新实体类型时继承即可自动适配,极大降低了模型扩展的维护成本。
我们设计的40多种实体类型都继承自8 个内核类型(Product、Service、Organization、Place、Activity、Event、CreativeWork、Policy)。比如定义一条边 LOCATED_IN: Product → Place,所有继承自 Product 的实体类型(CloudVM、CloudRDS、ArtifactInst 等)都自动合法,不需要逐一列举。新增一种实体类型时,只要声明它继承哪个基类,所有基于基类的边约束自动生效。
后记
我知道读到这里的同学可能会想:"这套东西听着很重,我一个小团队能搞得起吗?"
坦白说,确实需要一些前期投入。但我们实践下来发现,模型本身反而是最轻的一环——模型不用从0开始设计,而且40多种实体类型你不需要一上来就全用,从你核心的 3-5 种资源开始就够跑起来。
至于数据从哪来、怎么保持准确、Agent 操作生产环境的安全边界怎么设——这些确实没有一篇文章能讲完的,但这些问题的坑我们都踩过,也总结了解法。后续我会一个一个拆开聊,包括最小可启动的成本是什么、从零到跑通要多久。也很期待大家落地经验的分享和讨论!