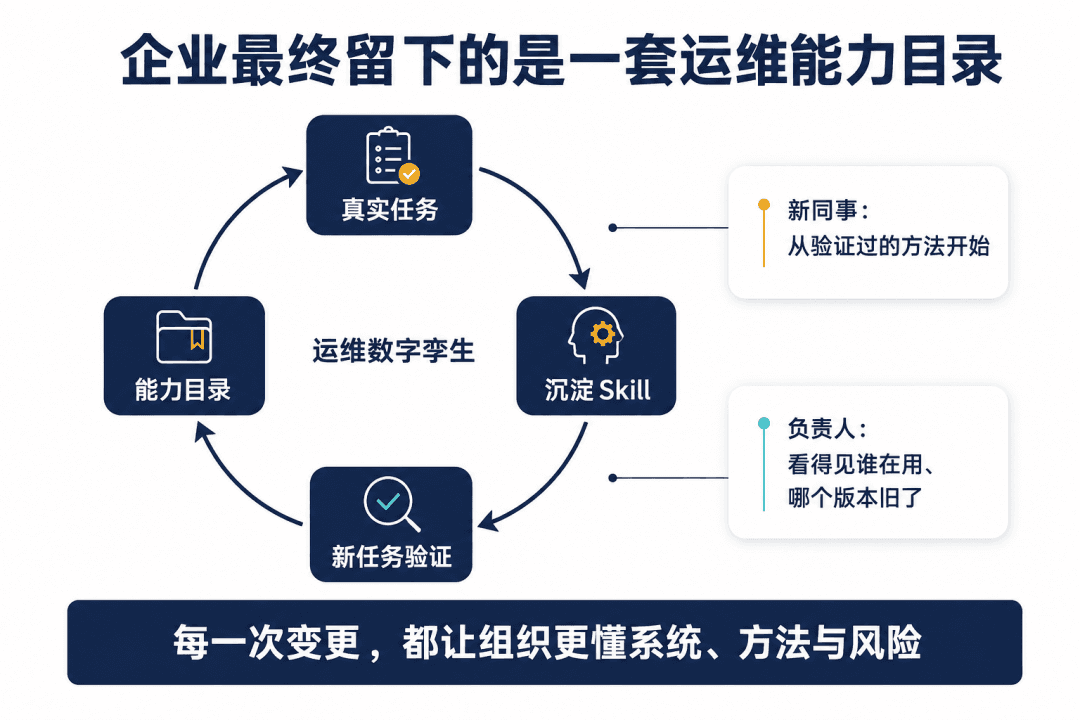
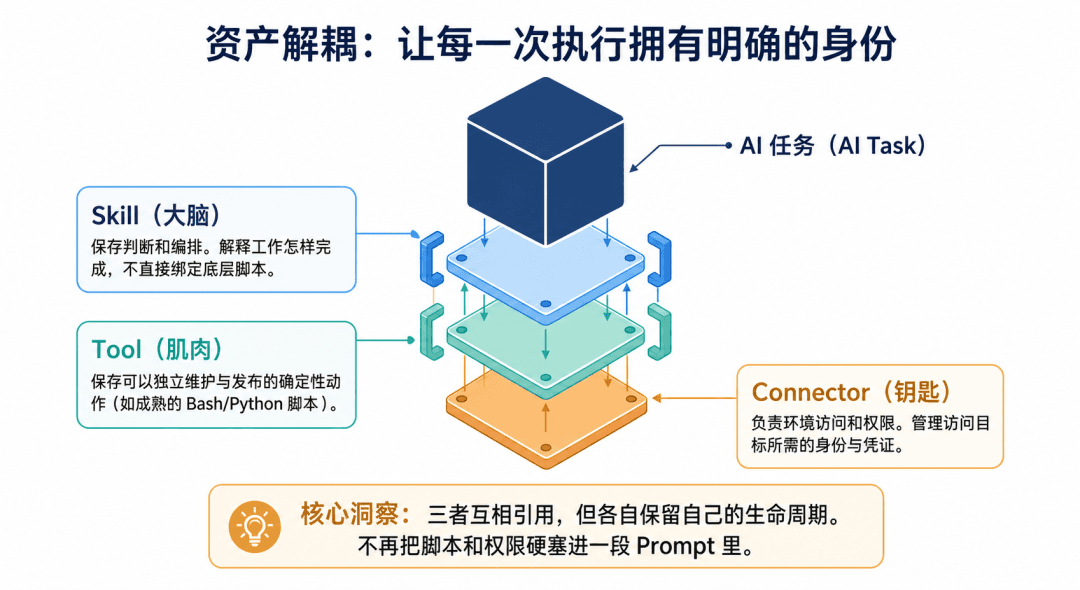
Loop Engineering 是最近 AI 圈内聊得最多的一个词。它在 Prompt、Context、Harness 之后,把 AI agent 之间的协作又往上推了一层。
Google 的 Addy Osmani 前阵子发了篇长文把它正式梳理了出来,大家可以去看看。
但更早之前,OpenClaw 的创始人 Peter Steinberger 说了句话,我觉得把这件事讲得最清楚:
你不应该再给 coding agent 写 prompt 了。你应该设计 loop,让 loop 去 prompt 你的 agent。
翻译成人话就是,你不再亲自一轮一轮地指挥 agent 干活了。你设计一个系统,系统自己去跑、去查、去修、去记,人从工人变成了工头。
要注意的是在运维领域里面,AI Agent的执行计划和安全绝对是最重要的。 如果缺乏护栏和人在回路,有可能会造成大的灾难,所以我并不看好那些“全自动”的运维Loop。
这篇文章,我用一个主机巡检的例子,带你看看是怎么从零开始构造一个安全的运维 loop 的。我们平常做的运维工作,都可以按这个套路封装成 loop。
Loop Engineering 拆解
如果我们把 Loop Engineering 这套体系拆开来看的话,它会有六个零件,
| 零件 | 做什么的 |
|---|---|
| Automations 心跳 | 定时或条件触发,loop 自己会跑,不用人推 |
| Worktrees 隔离 | 多个 agent 并行干活,各改各的文件,不打架 |
| Skills 技能文件 | 项目知识写下来,不用每个 session 重新解释 |
| Connectors 连接器 | 接外部系统,SSH、API、数据库,真的去执行 |
| Sub-agents 分工 | 写代码的和审查的分开,自己写的自己判太松 |
| State 状态 | 跨轮记住干了什么,agent 忘了文件不会忘 |
这些能力现在的 Claude Code / Codex 基本都内置了,不需要你从零开始搭建。
但有一个环节,工具替不了你。
把 loop 的结构和约束写下来。
你当然可以每次临时敲一个命令(比如claude code的 /goal 命令)。但有两个问题。
-
写 prompt 容易漏。 每轮跑几步、怎么判断跑完了、步骤之间怎么交接、越界了怎么拦,没人逼你想这些,你也可以不写。agent-runbook 的框架把这些都框死了,你不想也得想,漏了编译器就报错。
-
不可复用。 这次跑完下次换集群换人,又要重新来。
所以需要有一个地方,让你把 loop 的步骤、终态、护栏都写成一份文件。不是敲完就忘的 prompt,而是能持久化下来的契约。下次跑,下个人跑,用同一份契约,能产生同一个结果。
agent-runbook,把 loop 写成契约
agent-runbook 是一个在 Github 上的开源项目,github.com/KnoxOps/agent-runbook。它的核心思路就一句话,用契约约束 agent,而不是靠 prompt 碰运气。
几个关键的设计。
- 契约优先。 你写一份 YAML,声明这个 loop 的步骤、产出、依赖、护栏。不是写一段 prompt 说「帮我巡检一下」,而是把每一步的输入输出格式、执行顺序、越界条件都写死。编译器在生成技能文件之前就会检查,schema 文件缺了、步骤循环依赖了、引用了不存在的输出,当场报错。问题不会留到跑了一半才炸。
- 人必须在回路里。 运维跟测试不一样。测试环境 agent 能全自动修,生产环境不行。写操作的权力必须留在人手里。agent 可以 SSH 上去查、可以出方案、可以列命令,但最后敲不敲,你说了算。这个审批不是建议,是写在步骤结构里的硬节点,没通过就不往下走。
- 外部记忆。 agent 每轮执行完上下文就重置了。靠它自己记住上一轮干了什么,不靠谱。loop 把每轮的产出、迭代历史、整体进度全落在文件里,每个步骤跑完没跑完有状态文件记着,每轮修了什么有迭代日志记着。agent 忘了没关系,文件还在。
- 强制检查护栏。 prompt 里写「不要改配置」,agent 可以不理。agent-runbook 的护栏是强制检查,每轮结束后独立检查 agent 有没有越界,改了不该改的文件、执行了方案外的命令,这轮就不算完成。
- 自带刹车。 loop 必须写清楚什么算跑完了,还要设一个最大轮数,到了就停。不会让 agent 无休止跑下去。
- 步骤间靠文件通信。 不指望 agent 在长上下文里记住前一步说了什么。每步的产出有 JSON Schema 约束格式,下一步直接校验着读。字段对不上当场报错。
实战,一个主机健康巡检 Loop
举个真实场景。现在有一组生产服务器,定期巡检,磁盘、内存、负载、关键服务。发现问题不能全自动修,生产环境的写操作,必须有人审批。
这个 loop 每轮跑五步,
-
从巡检结果里挑出最严重的问题
-
SSH 上去查根因,出修复方案
-
方案亮给你看,等你点批准
-
批准了就执行
-
重新巡检,看问题还在不在
写成 Agent Runbook YAML 大概是这样:
name: host-health-loop
description: Ansible健康检查发现问题 → 逐一轮修复(写操作需人工审批)→ 复检 → 重复直到全健康 → 生成HTML报告

:
  - name: inventory
    type: string
    required: false
    description: Ansible inventory 文件路径,默认 ansible/inventory.ini
  - name: playbook
    type: string
    required: false
    description: 健康检查 playbook 路径,默认 ansible/health_check.yml

:
  - id: inspect
    type: script
    description: 运行 Ansible playbook 巡检所有主机,生成问题列表
    command: |
      ansible-playbook -i {inventory} {playbook} 2>&1
      mv /tmp/host_issues.json host_issues.json
    output:
      - file: host_issues.json
        schema: schemas/host_issues.schema.json
    depends_on: []

  - id: fix_loop
    type: loop
    description: >
      修复循环,每轮选最严重的问题,出方案,等人审批,执行修复,复检所有主机。
      重复直到没有问题或达到最大迭代次数。
    goal: "host_issues.json 中 total_issues 为 0(所有主机健康,无问题)"
    max_iterations: 10
    depends_on: [inspect]
    body:
      - id: select_issue
        type: inline
        description: 从 host_issues.json 中选出唯一最严重的问题
        prompt: |
          读取 host_issues.json 和 schemas/selected_issue.schema.json。

          按以下优先级选出唯一最严重的问题,
          1. critical disk(最高优先级)
          2. critical service_down
          3. critical memory
          4. critical load
          5. warning disk
          6. warning service_down
          7. warning memory
          8. warning load(最低优先级) 将选中的问题写入 selected_issue.json。
          如果 host_issues.json 中 total_issues == 0,写入 {"done": true}。
        depends_on: []
        output:
          - file: selected_issue.json
            schema: schemas/selected_issue.schema.json

      - id: plan_action
        type: agent
        description: 分析选中问题并生成具体修复方案(不执行)
        prompt: |
          读取 selected_issue.json 和 schemas/pending_action.schema.json。

          步骤一 — 调查,SSH 到目标主机查看实际情况。
          理解根因后再出方案。不要猜测,不要写泛泛的通用命令。

          步骤二 — 方案,基于调查结果,按 schema 将具体修复方案写入 pending_action.json。

          不要执行任何命令。只做调查和写 JSON 文件。
          如果 selected_issue.json 为 {"done": true},将 {"done": true} 写入 pending_action.json。
        depends_on: [select_issue]
        output:
          - file: pending_action.json
            schema: schemas/pending_action.schema.json

      - id: approve
        type: inline
        description: 人工审批门 — 展示修复方案,等待确认
        prompt: |
          读取 pending_action.json。

          如果为 {"done": true},跳过此步。

          否则,向操作人展示 pending_action.json 中的修复方案,

          ---
          ## 等待审批
          展示主机、问题、风险等级和待执行命令。

          输入 "approve" 执行,或 "reject" 跳过此问题。
          ---

          等待操作人明确回复。未经审批不得继续。
          审批通过则将 pending_action.json 复制为 approved_action.json。
          被拒绝则写入 skip_action.json,状态为 rejected。
        depends_on: [plan_action]

      - id: execute
        type: agent
        description: 执行已审批的修复操作
        prompt: |
          检查是否存在 approved_action.json。如存在,读取它。

          如果存在 skip_action.json,不执行——按 schemas/execute_result.schema.json 写入状态 "skipped"。

          执行修复,SSH 到目标主机,运行 approved_action.json 中列出的命令。

          规则,
          - 严格使用方案中的命令,不要即兴发挥
          - 命令失败不要重试
          - 执行后验证结果(如检查服务状态、磁盘用量)
          - 按 schemas/execute_result.schema.json 写入 execute_result.json 如果 pending_action.json 为 {"done": true},写入 {"status": "all_done"}。
        depends_on: [approve]
        output:
          - file: execute_result.json
            schema: schemas/execute_result.schema.json
        quality_check:
          blocking: true
          rules:
            - "命令严格按 approved_action.json 执行,未即兴发挥"
            - "未执行方案之外的破坏性操作"
            - "执行后已进行验证" - id: re_inspect
        type: script
        description: 重新巡检,刷新问题列表
        command: |
          ansible-playbook -i {inventory} {playbook} 2>&1
          mv /tmp/host_issues.json host_issues.json
        output:
          - file: host_issues.json
            schema: schemas/host_issues.schema.json
        depends_on: [execute]

  - id: generate_report
    type: agent
    description: 生成精美的 HTML 巡检和修复报告
    prompt: |
      读取最终 host_issues.json 获取当前健康状态。
      同时读取工作区所有 execute_result.json 了解修复内容。

      生成一份独立、精美的 HTML 报告,health_report.html

      包含,
      - 整体健康状态(全部正常 / 仍有问题)
      - 汇总统计,检查主机数、发现并修复的问题总数
      - 修复时间线,每轮迭代的主机、问题、调查发现、执行命令、前后对比
      - 最终各主机状态 设计要求,
      - 暗色主题,现代仪表盘风格
      - CSS grid/flexbox,无外部依赖
      - 移动端适配
      - 专业且视觉精美——这是生产报告
      - 所有 CSS 内联在 <style> 标签中
    depends_on: [fix_loop]
写完 YAML,一条命令编译成技能文件,
python3 -m agent_runbook generate runbook.yaml -o output/
装进 Claude Code / Codex 就能跑了。
生成的 SKILL.md 全量大概 250 行,这里是精简过的关键段落,完整版在github仓库里面有: https://github.com/KnoxOps/agent-runbook/blob/master/examples/host-health-loop/output/SKILL.md 。
---
name: host-health-loop
description: Ansible健康检查发现问题 → 逐一轮修复(写操作需人工审批)→ 复检 → 重复直到全健康 → 生成HTML报告
user-invocable: true
---

## Execution Flow

### Task Context
初始化 task_context.json,记录每个步骤的状态。跑完一步更新一步,断了从断点续跑。

### Step 1: inspect
**Type:** script
运行 ansible-playbook 巡检所有主机,产出 host_issues.json。

### Step 2: fix_loop
**Type:** loop
**Goal:** host_issues.json 中 total_issues 为 0
**MaxIterations:**10

每轮 body,
1. select_issue — 按优先级选出最严重的问题
2. plan_action — SSH 调查根因,出修复方案(不执行)
3. approve — 展示方案,等待人工审批
4. execute — 执行已审批命令,quality_check 检查越界
5. re_inspect — 重新巡检,刷新问题列表

## Goal Evaluation
1. goal 满足 → 标记完成,进入下一步
2. goal 未满足且未到上限 → 开始下一轮
3. 达到 max_iterations → 标记完成,报告剩余问题

每轮结束追加 iteration_history。

### Step 3: generate_report
**Type:** agent
读取最终巡检结果和修复记录,生成浅色仪表盘风格 HTML 报告。

...
你会发现,这份 YAML 其实就是在声明 Loop Engineering 的六个零件。你声明了,Claude Code / Codex 自动帮你跑起来,
| 你在 YAML 里声明了 | Claude Code / Codex 自动做的事 |
|---|---|
| 每一步谁跑、干什么、什么顺序 | 按声明顺序起 agent,分配独立的执行环境,跑完自动回收 |
| 每步产出的格式要求 | 跑完自动校验输出对不对,不对立刻报错 |
| 怎么连外部系统(SSH、Ansible、API) | 通过连接器连真实服务器,真的去执行 |
| 什么算搞定、最多跑几轮 | 每轮结束自动判断是否达标,到上限就停,不烧冤枉 token |
| 审批要等人点头、越界要拦住 | 写操作的命令亮给你看,等你批了才继续。每轮跑完检查有没有越界,越界不算完 |
实际效果,五轮全绿
这个例子在 3 台测试机上实测过。初始巡检发现多个问题,分布在不同机器上。
- 第一轮一台机器根磁盘 93% 满了。agent 上去查,Docker 日志涨到 5.4G,/tmp 堆了 4.5G。需要人工审批。
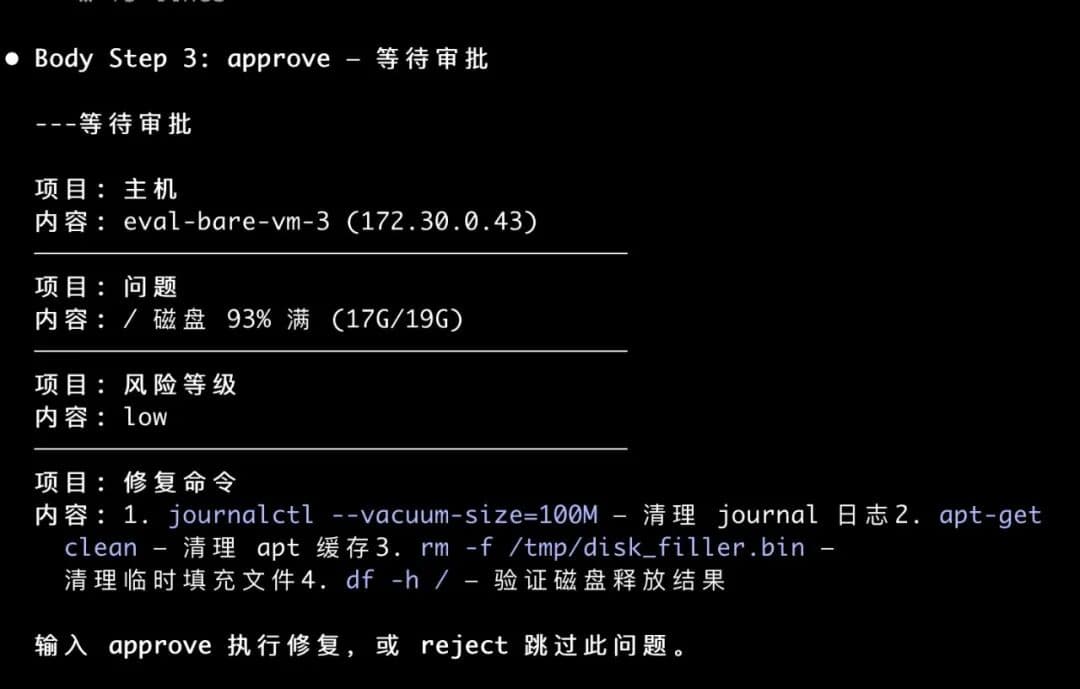
- 审批后清理,释放了 10G,磁盘降到 38%。
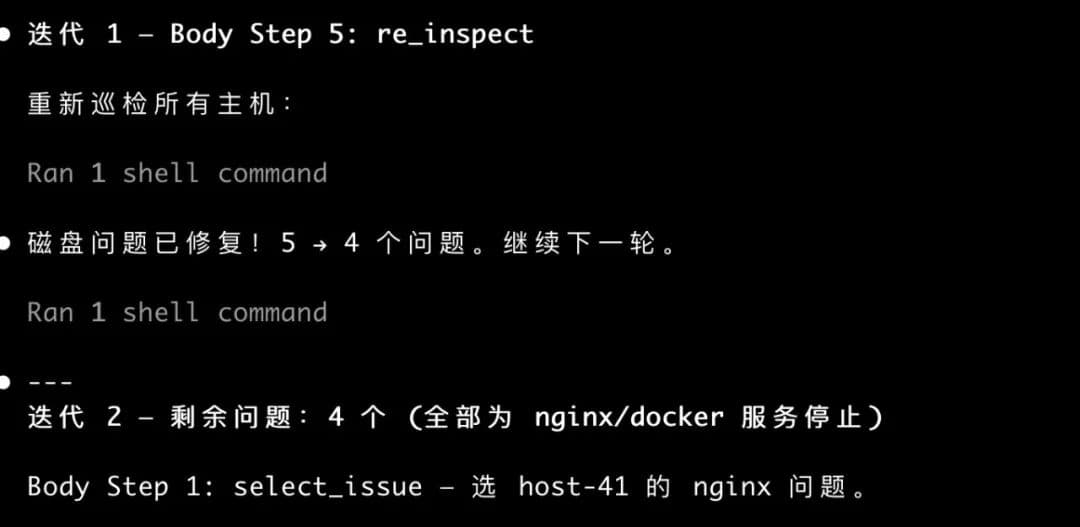
-
后面几轮是三台机器上的 nginx 和 docker 被人停了没恢复。每轮都是查 → 出方案 → 审批 → 执行 → 确认服务起来。五轮跑完,全部健康,Loop 自动停。
-
生成了浅色仪表盘风格的 HTML 报告。
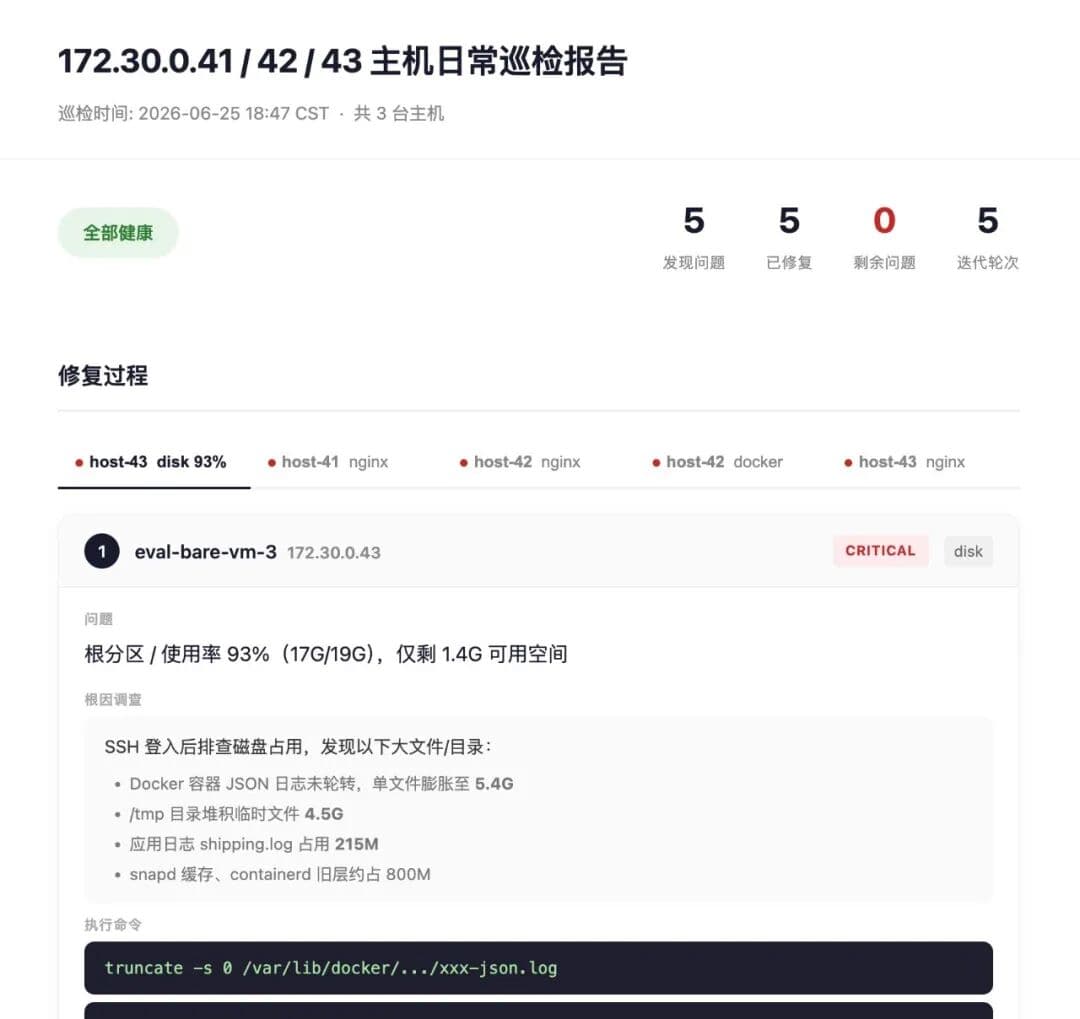
注意全程所有写操作都走了审批。不是自动拍板敲命令,是人看过才放行。生产环境,这个不能省。
设计运维 Loop 的几个要点
- 选对任务。 好的运维 Loop,问题之间有客观的反馈信号,巡检结果、指标数据、健康检查端点,能跑完一轮自动判断下一轮还要不要继续。问题之间相对独立,可以逐个收敛。主机巡检、证书过期扫描、K8s pod 重启循环排查、Prometheus 告警风暴分类、日志异常模式匹配,都是好选手。需要全局判断的,容量规划、架构调整,不适合塞进 Loop。
- 什么算完,写成机器能自己判断的。 「问题列表清零」是好条件,「集群状态良好」不是。agent 必须能自己读一个文件或跑一条命令来判断真假。写条件的时候问自己,这个能不能让一个脚本在一行里判出来。不能的话 agent 也判不准。
- 步骤之间靠文件传数据,别靠记忆。 前一步的输出就是下一步的输入,格式有约束,错了马上发现。agent 记性不好,上下文一长就忘。文件不会忘。
- 写操作,拦一道。 测试环境可以全自动。生产不行。审批这一步是整个 Loop 的安全阀。把审批写在契约里,比写在 prompt 里可靠一百倍。
- 留个上限。 最大迭代数不是你的期望轮数,是「超过这个数说明有问题」的断头路。正常应该在远低于上限的时候就收敛。跑满了,说明某些问题修不掉或者巡检在反复报假阳,需要人介入。
收个尾
agent-runbook 本身的定位很轻。它不是 Loop Engineering 的全套实现,它只管一件事,把 loop 的结构写成声明文件。写完了,Claude Code / Codex 自己去跑。
你也不需要从零开始。github项目的examples 目录 下就有这个主机巡检 Loop 的完整代码,runbook 文件、巡检脚本、实际跑出来的修复记录,全在。
不只主机巡检。证书过期扫描、K8s 节点健康检查、日志归档清理、数据库备份验证、中间件配置合规扫描,只要你的运维任务能拆成「步骤 + 契约 + 依赖关系」,就能写成一个 loop。
repo 在 github.com/KnoxOps/agent-runbook。如果你有反复手动跑 Ansible、SSH 上去查问题再修的日常,试着把这套流程写成一份声明,让工具去跑。它会比你自己跑的时候规矩得多。